Hübsche KI-Bilder sind der Normalfall, darauf sind die Modelle trainiert. Der Unterschied zum außergewöhnlichen Bild entsteht nicht an der Promptformel, sondern an gestalterischen Entscheidungen, die jemand getroffen und formuliert haben muss.
Ich habe denselben Bildinhalt zweimal gepromptet. Einmal in einem Satz: ein Marktstand in einer Markthalle, ein Händler davor, Kunden im Hintergrund. Einmal in 179 Wörtern, mit Lichtquelle und Lichtrichtung, Kamerahöhe, Schärfeverlauf, einer einzigen gesättigten Farbe und der ausdrücklichen Angabe, dass die Kundschaft im Hintergrund als Silhouette bleibt. Beide Versionen gingen an dieselben drei Modelle: Grok Imagine, GPT Image 2.5 Sunburst und Nano Banana Pro.
Hübsch ist die Voreinstellung
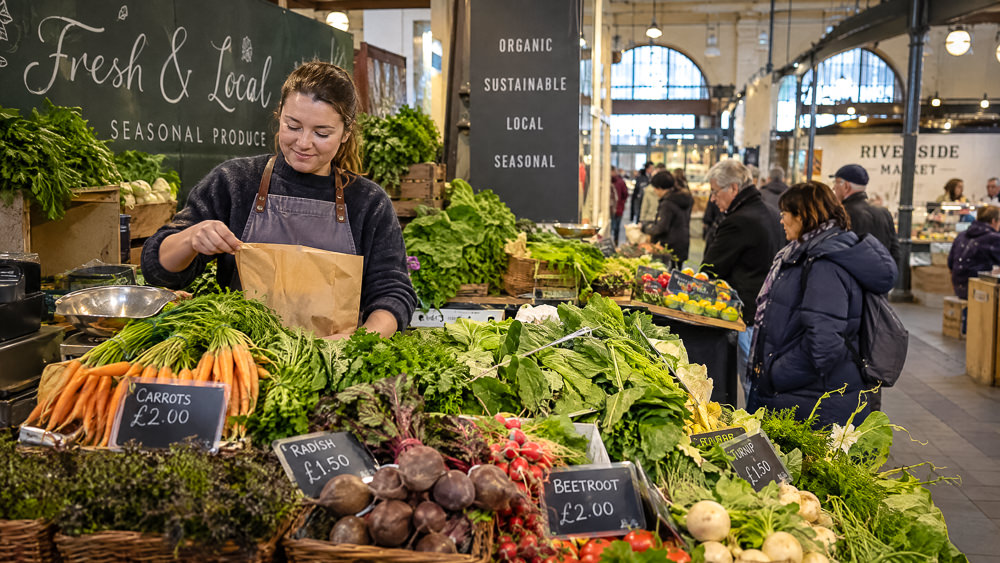
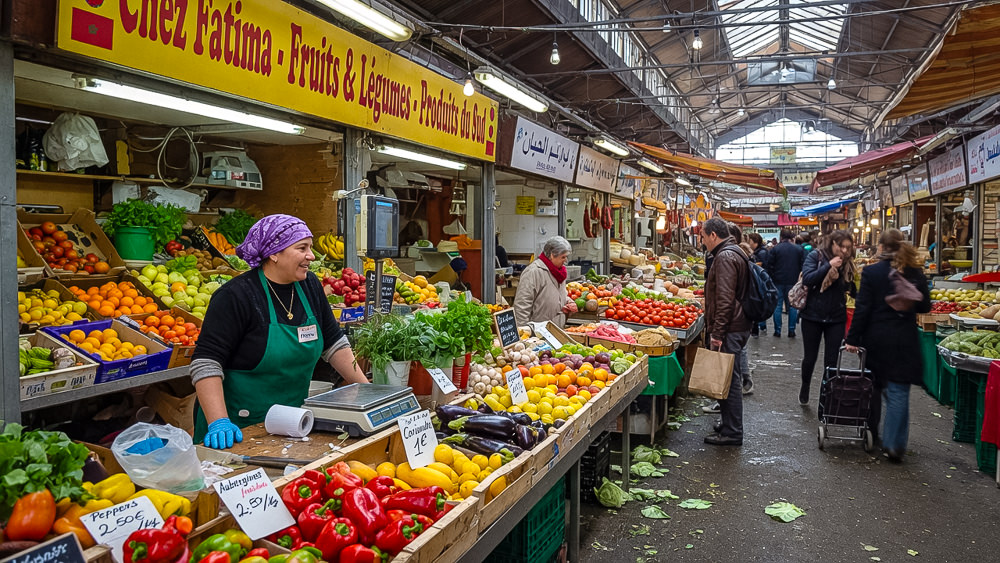
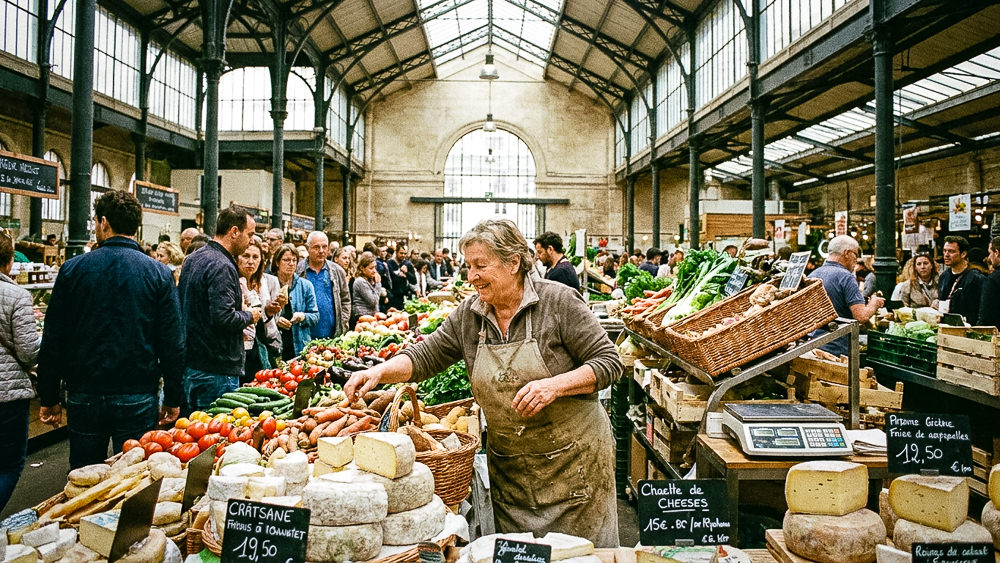
Aus dem kurzen Prompt kamen drei gute Bilder und alle drei zeigen dieselbe Weitwinkelaufnahme einer Markthalle: eine lächelnde Person hinter der Auslage, jeweils von der ersten Kiste bis zur Hallenrückwand durchgezeichnet, in weichem Deckenlicht ohne erkennbare Richtung. Dazu erfundene Schilder und Tafeln wie „Fresh & Local“, von denen im Prompt nichts stand. Die Modelle liefern den Look der Werbebildwelt. Warum dies das trainierte Ziel ist und was das mit einer eigenen Trainingsstufe nach dem Haupttraining zu tun hat, habe ich an anderer Stelle ausführlicher beschrieben. Für diesen Artikel reicht die praktische Folge: Was Sie nicht entscheiden, entscheidet die statistische Mitte — und die ist durchschnittlich typisch.
Das Auge erkennt, es benennt nicht
Damit ist die Folie erklärt, die ich am Anfang in meinen Seminaren zeige: KI ersetzt kein gutes Auge, sie zeigt, wer eines hat. Wer fotografiert, trifft dieselben Entscheidungen ständig, nur wortlos. Sie gehen zwei Schritte nach links, weil das Gegenlicht dann trägt. Sie warten, bis sich die Gruppe im Hintergrund aufgelöst hat. Sie öffnen die Blende, weil die zweite Standreihe nichts beiträgt. Keine dieser Entscheidungen muss je einen Namen bekommen, das Ergebnis ist der Beweis. Ein Prompt verlangt genau diesen Namen. Die zwei Schritte nach links werden zu einer Angabe über Lichtrichtung, das Warten zu einer Angabe über die Menge im Hintergrund, die offene Blende zu einer Angabe darüber, wo die Schärfe abfällt.
Wer nicht sehen kann, kommt über hübsch nicht hinaus, und wer es kann, muss es zusätzlich in Worte bringen. Genau hier scheitert auch die Erwartung, KI-Bilder machten Fotografie überflüssig. Die Modelle liefern jedem ein vorzeigbares Bild, aber niemandem eine Entscheidung. Erlernbar ist das Sehen für jeden, überspringen lässt es sich mit keinem Prompt.
Was Sie nicht entscheiden, würfelt das Modell
Zwei Felder zeigen das besonders deutlich, weil ihre Auslassung nicht als Auslassung auffällt.
Farbe. Was Sie nicht benennen, würfelt das Modell aus: die Farbe und den Gegenstand, an dem sie sitzt. „Gedämpfte Palette mit einem warmen Akzent“ hat keinen Ort im Bild, also landet der Akzent irgendwo oder gar nicht. Eine Kiste Blutorangen als einzige gesättigte Farbe hat einen Ort, und im englischen Prompt steht das als one crate of blood oranges the only saturated colour in the frame. Sättigung braucht einen Träger, kein Adjektiv.
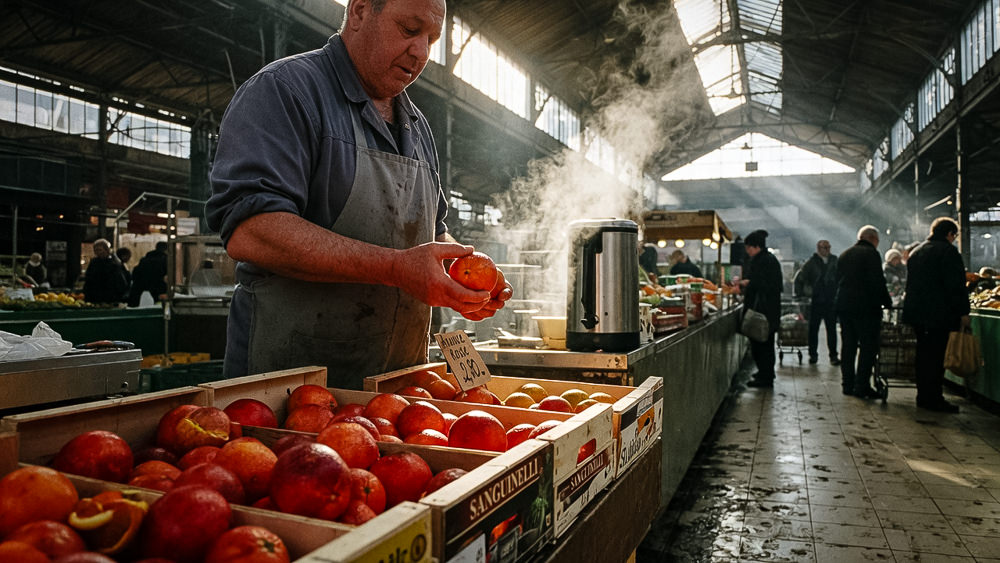
Detailtiefe. Stabilität entsteht durch Genauigkeit: Eine dichte Beschreibung bindet, eine allgemeine bildet auf tausend Möglichkeiten ab und driftet. Daraus folgt beides. Wo Sie ein Gesicht halten wollen, beschreiben Sie dicht. Und wo Sie keines brauchen, sagen Sie das ausdrücklich, sonst verteilt das Modell den Aufwand über alle Figuren und keine wird stabil. Im Prompt steht dafür the customers further back read as silhouettes only, unnamed and interchangeable — die Kundschaft bleibt Silhouette, ohne einzeln gehaltene Gesichter. Das ist Bildaufbau in Prompt-Form: Was trägt, was ist Fläche.
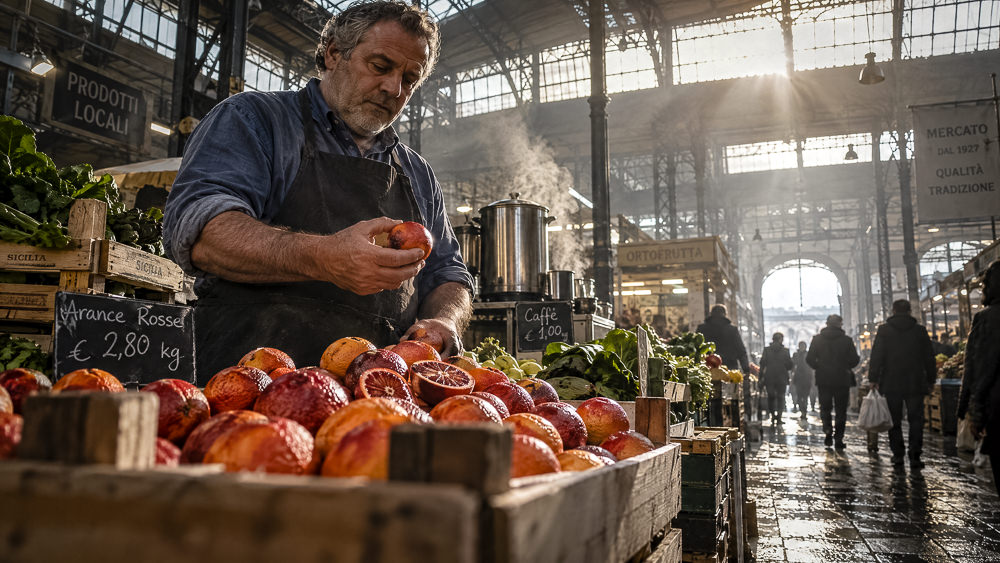
Genau diese beiden Angaben fehlen in der Ein-Satz-Fassung, und genau dort unterscheiden sich die drei Bilder in allem außer dem, worauf es ankommt.
Das Modell nimmt Sie beim Wort
Der lehrreichste Durchgang war der, der nicht nach Plan lief. Der lange Prompt beginnt mit der Gattungsangabe Documentary photograph und endet mit dem Anker Working-day documentary. Zwei der drei Modelle haben das umgesetzt wie beschrieben: Gegenlicht durch die Oberlichter, der Dampf einer Kaffeemaschine macht den Strahl sichtbar, die Kundschaft steht als Silhouette im Gegenlicht, die Blutorangen liegen als einziger kräftiger Ton im Vordergrund.
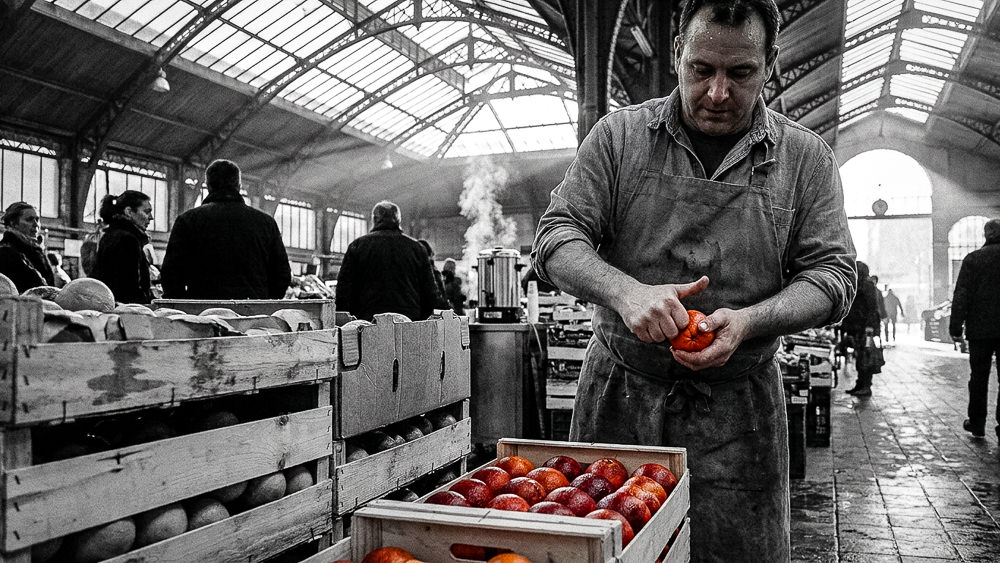
Das dritte Modell, Nano Banana Pro, hat das Bild schwarzweiß angelegt, bis auf die Kiste Blutorangen, die ihre Farbe behalten hat. Damit ist der Prompt erfüllt, und zwar genauer, als er gemeint war. Dort steht, die Blutorangen seien die einzige gesättigte Farbe im Bild — eine relative Angabe, die nichts darüber sagt, wie viel Farbe der Rest behalten darf. Das Modell hat sie maximal eingelöst und alles andere auf null gezogen. Herausgekommen ist ein Colorkey-Effekt, den ich weder gewollt noch ausgeschlossen habe.
Vermutlich hat die Gattungsangabe mitgearbeitet, denn Dokumentarfotografie ist in den Trainingsdaten über weite Strecken schwarzweiß, und jeder Begriff schleppt seine gewohnte Umgebung mit: Falten bringen Alter mit, Schweiß bringt Hitze mit, eine Gattungsbezeichnung ihre Bildtradition. Aus einem einzelnen Durchgang lässt sich beides nicht auseinanderhalten. Die Lehre ist in beiden Fällen dieselbe, nämlich dass eine Angabe exakt befolgt werden und das Bild trotzdem kippen kann, weil sie mehr zulässt, als beim Schreiben gemeint war.
Die Korrektur ist eine Zeile lang: Eine relative Angabe braucht ein Niveau für alles andere, etwa dass die übrigen Farben gedeckt bleiben, aber lesbar. Auch das ist eine gestalterische Entscheidung, allerdings eine, an die man beim Fotografieren nie denken muss.
Die Reihenfolge schlägt die Länge
Die Reaktion auf so einen Fehlversuch ist häufig, länger zu prompten. Das hilft aber nur bedingt. Der Benchmark SpatialGenEval hat im Januar 2026 23 Bildmodelle mit 1.230 informationsdichten Prompts von durchschnittlich 66 Wörtern geprüft und für jedes Bild abgefragt, ob die beschriebenen Objekte, Positionen und Beziehungen tatsächlich zu sehen sind. Getestet wurden auch die Modelle, die derzeit vorn liegen, darunter Nano Banana und GPT-Image. Das beste kam über alle Kategorien auf knapp 63 Prozent.
Interessanter als die Rangliste ist das Gefälle darin. Objekte und ihre Eigenschaften kommen bei den Spitzenmodellen zu 70 bis 80 Prozent an: Was im Bild ist und welche Farbe, welches Material, welche Form es hat, wird zuverlässig umgesetzt. Sobald es darum geht, was im Verhältnis zu was wie groß ist oder was wovon verdeckt wird, fallen dieselben Modelle unter 30 Prozent — und bei vier Antwortmöglichkeiten liegt der Zufall bei 20.
Zwei Einschränkungen gehören dazu. Gemessen wurde Anweisungstreue, nicht Bildwirkung, und ein Bild kann jede Positionsangabe verfehlen und trotzdem gut sein. Und die Prompts waren mit 66 Wörtern kürzer als das, was ich schreibe; dass die Trefferquote zusätzlich sinkt, je länger der Prompt wird, hatte ein früherer Benchmark im Mai 2025 für die damaligen Modelle gezeigt.
Aus derselben Untersuchung stammt der praktisch wichtigste Befund. Wurden die Prompts klarer und eindeutiger umformuliert, stiegen die Werte für Position, Anordnung und Größenverhältnisse spürbar – für Verdeckung und Ausrichtung blieben sie nahezu unverändert. Ein Teil der Fehler ist also ein Formulierungsproblem und lässt sich durch Umschreiben lösen. Der andere Teil ist keins, und dort hilft nur ein anderer Bildaufbau und ein zweiter Durchgang.
Für die Praxis der KI-Bildgenerierung heißt das, dass nach vorn gehört, was gegen die Erwartung des Modells arbeitet, und nicht das, was Ihnen am wichtigsten ist. Eine Lichtangabe hält auch am Ende eines langen Prompts, weil sie keinen Gegner hat. Eine seltene Form, eine ungewöhnliche Pose, eine Menge ohne Gesichter kämpft gegen ein dichtes Trainingsmuster und muss in die ersten Zeilen.
Wo das fotografische Wissen wirklich zahlt
Der Vorteil eines Fotografen liegt darin, dass er für all das Begriffe hat. Streiflicht, Gegenlicht, Tiefenstaffelung, Bildschnitt, Farbdominanz: Wer diese Dinge benennen kann, hat den Übersetzungsschritt halb hinter sich. Wer sie nicht benennen kann, schreibt „schönes Licht“ und bekommt das Licht der Trainingsmehrheit.
Die Übertragung endet allerdings an einer bestimmten Stelle, und die ist es wert, genau markiert zu werden. Fotografisches Vokabular überträgt sich als Wirkung, nicht als Gerät. Mit Schärfentiefe lässt sich arbeiten, mit einer konkreten Blende nicht — „f/1.4″ ist eine Einstellung am Objektiv, die kein Bildmodell rechnet, während focus plane on the eyes, ears already soft beschreibt, was im Bild zu sehen wäre. Brennweitenangaben funktionieren bei mir ähnlich: „35mm“ ruft eher den Look einer Aufnahmeart ab als eine Geometrie.
Dasselbe gilt für Angaben, die im Bild schlicht nicht oder nur ansatzweise ankommen. Der tiefe Standpunkt, den ich über die Obstkisten hinweg wollte, wurde in allen drei Bildern zu leicht abgesenkter Brusthöhe. Und der Daumen, der sich sichtbar in die Schale einer Blutorange drückt, fehlt oder steckt zu tief in der Orange. Beides fällt in genau die Kategorien, in denen die Modelle im Benchmark unter 30 Prozent liegen.
Unter dem Strich liefert der lange Prompt drei Bilder, in denen man die Entscheidungen sehen kann, statt dreimal derselben Markthalle.
Der Unterschied entsteht vor dem Bild
Am Anfang standen sechs Bilder, drei aus einem Satz und drei aus 179 Wörtern. Der Unterschied zwischen ihnen ist keine Frage der Modellqualität, denn es waren dieselben Modelle. Er ist auch keine Frage der Promptlänge, denn aus demselben langen Prompt kam auch das Bild, das am weitesten vom Plan abwich.
Er besteht darin, dass jemand vorher entschieden hat, woher das Licht kommt, was scharf ist, welche Farbe trägt und wer im Hintergrund ein Gesicht behält. Das sind die Entscheidungen, die Sie am Stativ ohnehin treffen. Ein Bildmodell nimmt sie Ihnen nicht ab, es verlangt sie nur früher und zum ersten Mal in Worten.
FAQ: Gestaltung von KI-Bildern
Weil ein kurzer Prompt fast alles offenlässt und die Lücken von der statistischen Mitte des Trainingsmaterials gefüllt werden. Die Mitte sieht in allen großen Modellen ähnlich aus, weil das Material sich überschneidet: Werbebilder, Stockfotografie, Social-Media-Aufnahmen. Die Motive unterscheiden sich dann, die Kamerahöhe, das Licht und die Anmutung nicht.
Was heißt „gutes Auge“ beim Prompten konkret?
Es heißt, die Entscheidungen zu kennen, die man beim Fotografieren wortlos trifft: Lichtrichtung, Kamerahöhe, Bildschnitt, Schärfeverlauf, Farbdominanz, Tiefenstaffelung. Beim Fotografieren fallen sie im Sucher, beim Prompten müssen sie ausgesprochen werden. Das Erkennen ist die Voraussetzung, das Benennen ist die eigentliche Arbeit.
Reicht es, einen längeren Prompt zu schreiben?
Nein, Länge allein verschlechtert das Ergebnis eher. Der Benchmark SpatialGenEval hat im Januar 2026 für 23 Modelle gezeigt, dass Objekte und ihre Eigenschaften zu 70 bis 80 Prozent ankommen, Größenverhältnisse und Verdeckungen dagegen unter 30 Prozent liegen. Entscheidend ist, welche Angaben früh stehen: Was gegen ein dichtes Trainingsmuster arbeitet, gehört nach vorn, Licht und Atmosphäre halten auch am Ende.
Warum wird eine Farbangabe manchmal ignoriert?
Meist, weil sie an keinem Gegenstand hängt. Eine Angabe wie „gedämpfte Palette mit warmem Akzent“ beschreibt eine Stimmung und hat keinen Ort im Bild, deshalb fällt sie weg. Hängt dieselbe Farbe an einem Objekt — eine Kiste Blutorangen, ein rotes Vordach —, wird sie gezeichnet.
Was ist mit Blende, ISO und Brennweite?
Schärfentiefe lässt sich steuern, eine konkrete Blende nicht: Bildmodelle rechnen keine Optik, sie reproduzieren Bildlösungen. Wirksam ist die Beschreibung dessen, was zu sehen wäre, etwa dass die Augen scharf sind und die Ohren schon nicht mehr. Brennweitenangaben funktionieren bei mir eher als Stilanker für eine Aufnahmeart als als geometrische Vorgabe.
Meist, weil die Farbangabe relativ formuliert war. Wer schreibt, ein Gegenstand sei die einzige gesättigte Farbe im Bild, sagt nichts darüber, wie viel Farbe alles andere behalten soll — und ein Modell darf das als Null lesen. Geben Sie deshalb auch für den Rest ein Niveau an, und prüfen Sie zusätzlich, ob eine Gattungsangabe wie Dokumentarfotografie ihre eigene Bildtradition mitbringt.
Lohnt sich der Aufwand, wenn das nächste Modell ohnehin besser wird?
Die Physik-Fehler werden mit jeder Generation seltener, die Neigung zum Gefälligen nicht, weil sie bewusst antrainiert wird. Ein besseres Modell liefert eine sauberere Fassung derselben Mitte. Die Entscheidung, welche Mitte Sie verlassen wollen, kann es nicht treffen.
Die beiden Prompts
Prompt A, kurz: A photo of a market stall in a market hall, a vendor in front, customers in the background.
Prompt B, 179 Wörter: Documentary photograph. A market hall at opening time, seen from low over the crates of a produce stall, the near crates cutting into the bottom edge of frame. Behind the stall a vendor in his fifties, heavy grey apron over a washed-out blue shirt, forearms bare, his thumb pressed into the skin of a blood orange, the dimple holding. The customers further back read as silhouettes only, unnamed and interchangeable, no individual faces held. Beyond them a riveted iron roof structure and a wet tiled floor, the far end of the hall losing contrast and detail in the light. Hard morning sun through the roof skylights from behind the stall, the steam off a coffee urn carrying the beam. Highlights burning out along the skylight band, the shadow side of the apron dropping to black without detail. One crate of blood oranges the only saturated colour in the frame. 35mm, low angle, MS, shallow depth of field, the second row of stalls already soft. Sebum sheen on his forehead, damp wood and wet cardboard under the crates. Working-day documentary.